
こんにちは。
たいしゅうです。
先日アメリカラスベガスにて、あのビッグイベントが今年も行われました。
そう「AWS re:Invent」です。今回のre:Inventでは多くの新サービス、アップデート情報がありましたが、その中で、今回は、機械学習サービスのAmazon SageMakerについて概要をご紹介します。
概要
Amazon Sagemakerは、これまでAmazonで提供されていたAmazon MachineLearningとは違い、アルゴリズムなどをある程度ユーザー側で制御できるようなサービスです。
また、既存の機械学習フレームワーク(TensorFlowなど)を利用することもできます。
Sagemakerは、下記のようにいくつかのフェーズに分かれて、利用をしていきます。
1、 構築
2、 学習(チューニング)
1、 構築
2、 学習(チューニング)
3、 デプロイ
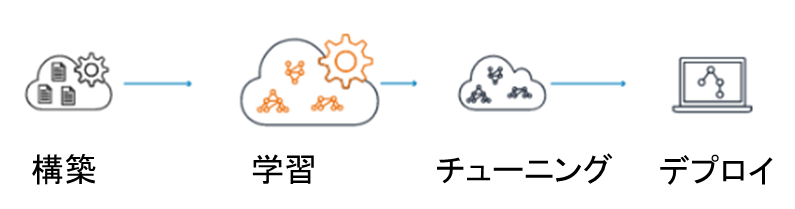
それでは、それぞれの工程の概要について説明していきたいと思います。
構築
構築フェーズは、モデル作成の準備が可能です。
この構築フェーズでは、主に以下のことができます。
1,IAMロールの設定
Sagemaker用のIAMロールをデフォルトで設定することもできます。
2,ノートブックインスタンスサイズ選択
Jupiterノートブック※の作成をすることができます。
t2.medium、m4.xlarge、p2.xlargeの3つのサイズから選択して、立ち上げられます。
ノートブックインスタンスは、利用する際に起動させることができるので、無駄なく利用ができます。
※Jupiterノートブックとは、ノートブックと呼ばれる形式で作成したプログラムを実行し、実行結果を記録しながら、データの分析作業を進めるためのツール
学習
学習フェーズでは、アルゴリズムの選択、学習用インスタンスの立ち上げ、入力データ出力データの選択など
学習をする為に必要な項目を設定することができます。
TensorFlowなどの既存ワークフレームも利用ができます。
この学習フェーズでは、主に以下のことができます。
1,ジョブ設定
IAMロールの選択、アルゴリズムの選択、学習用インスタンスの実行数量と停止時間の設定などができます。
2,ハイパーパラメータ設定
上記で選択したアルゴリズムに合わせて、ハイパーパラメータを細かく設定することができます。
3,入力データ設定
入力データ(学習用データ)がどこにあるかを選択することができます。
4,出力データ設定
どこに結果を出力するかを設定できます。
デプロイ
デプロイフェーズでは、実際に作成した予測モデルを実装するために必要な機能が利用できます。
モデルをワンクリックで複数の可用性ゾーンにまたがるEC2インスタンス(オートスケール可)に展開することで、高い冗長性を実現できます。EC2インスタンスのタイプと必要な最大値と最小値を指定するだけで、Amazon SageMakerが残りの処理を行います。インスタンスを起動し、モデルを展開し、アプリケーションのセキュアなHTTPSエンドポイントを設定します。
デプロイフェーズでは以下のようなことができます。
・APIコールで既存アプリケーションに統合可能
APIコールを使うことで、既存のアプリケーションに統合することが可能
・自動A / Bテスト
Amazon SageMakerはモデルA / Bテストを管理することもできます。エンドポイントを設定して、最大5つの異なるモデル間でトラフィックを分散させ、それぞれが処理したいと考える推論呼び出しの割合を設定できます。どのモデルが最も正確な結果を出すかを柔軟に判断できます。
・運用管理
Amazon CloudWatchの監視およびログ機能を使用して、ヘルスチェックの実施、セキュリティパッチの適用、その他の日常的なメンテナンスを行うために、プロダクションコンピューティングインフラストラクチャを管理します
まとめ
Amazon Sagemakerが登場したことで、機械学習の利用がさらに身近なものになるのではないかという印象を受けたものの、アルゴリズム選択やパラメータ設定を自分で行う必要があり、機械学習を知らない人が利用するには少しハードルが高いのではないかと思いました。
今度は、実際に利用をしてみて、手順などの紹介をできればと思っています。
今回は、以上になります。
最後まで読んでいただきありがとうございました。

