
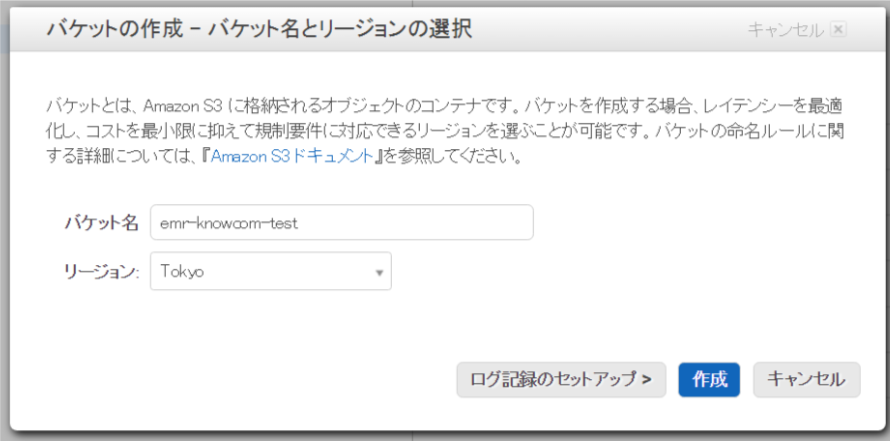
データのinputやoutputに利用するS3バケットを作成します。今回はTokyoリージョンに作成しました。
※EMRと別のリージョンにバケットを作成すると転送量が発生するため注意が必要です!
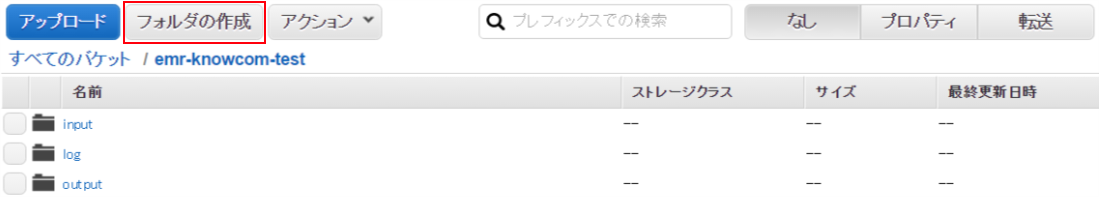
作成したバケット下にデータのinputとoutputを行うフォルダを作成します。
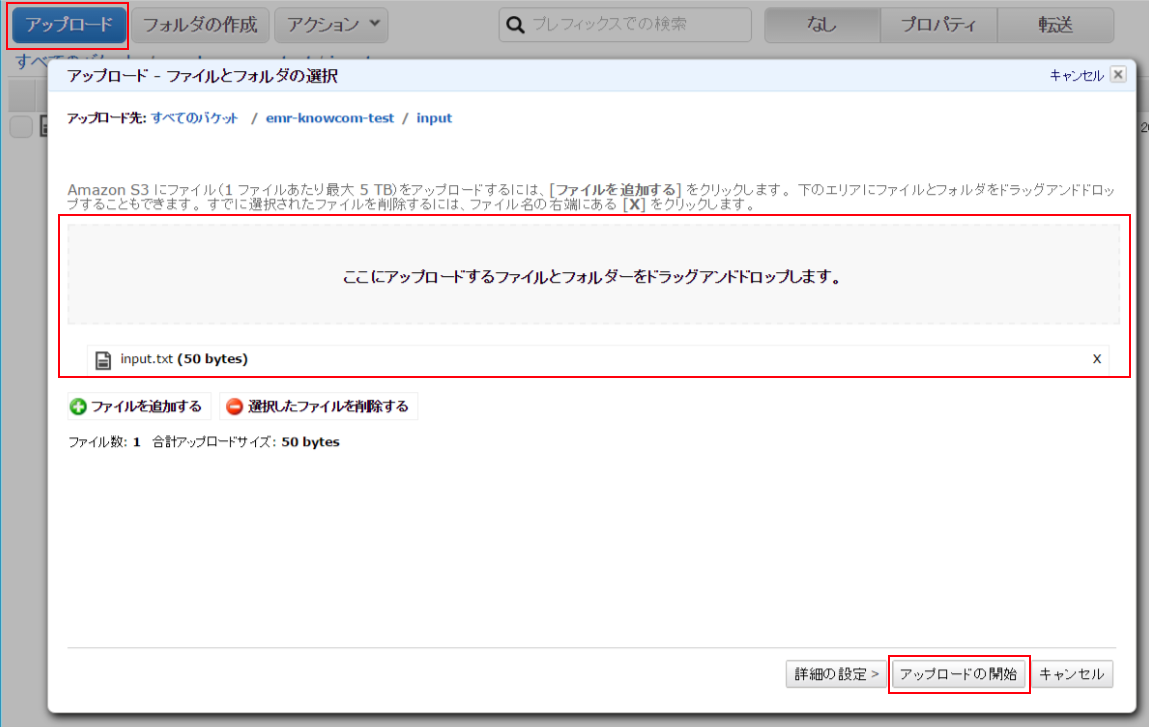
解析するデータのアップロード
アップロードするデータとしてinput.txtというタブ区切りのファイルを作成します。
1two five four one four three five2three three five two five five four fourこちらを先程作成したバケットのinputフォルダにアップロードします。
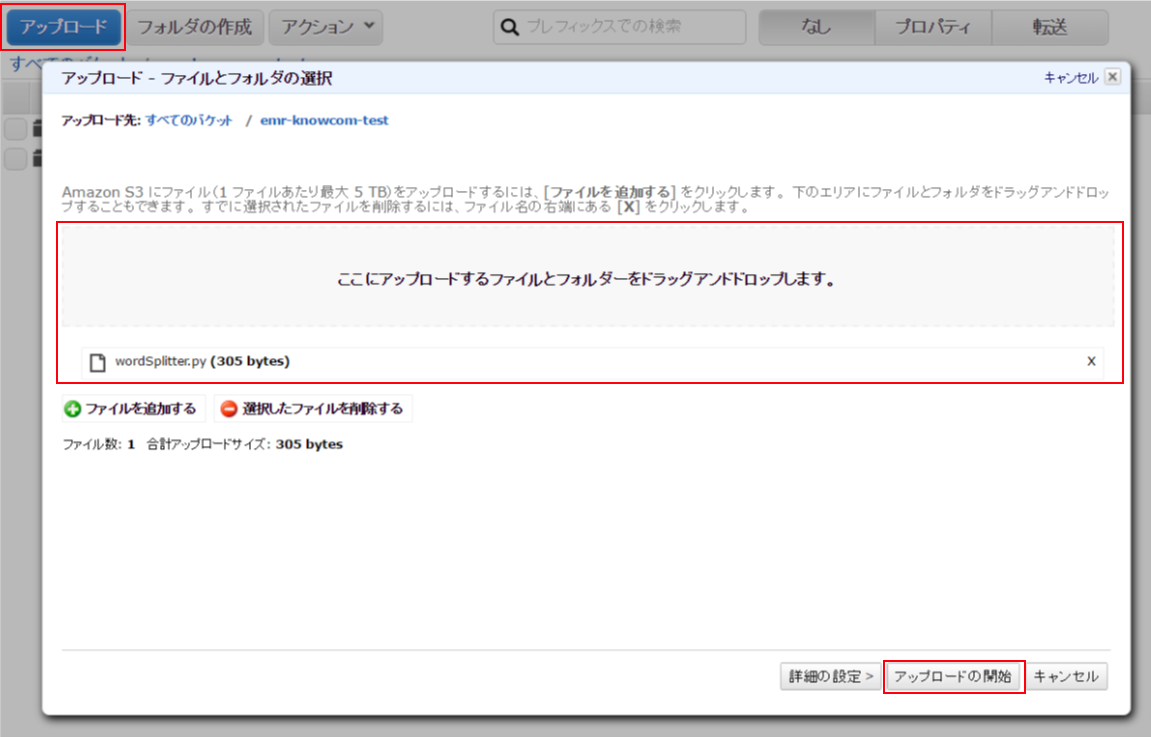
スクリプトのアップロード
今回は「Streaming」というJOBタイプを利用します。
「Streaming」ではPython, Ruby, Perl, PHP, R, Bash, C++などの言語が利用可能です。
今回はPythonで記述されたサンプルスクリプトを用います。
1#!/usr/bin/python2import sys 3import re 45def main(argv): 6 pattern = re.compile("[a-zA-Z][a-zA-Z0-9]*") 7 for line in sys.stdin: 8 for word in pattern.findall(line): 9 print "LongValueSum:" + word.lower() + "\t" + "1" 1011if __name__ == "__main__": 12 main(sys.argv)[こちら ]からもダウンロードが可能です。
こちらのファイルは先程作成したS3バケットの直下にアップロードします。
これでEMRを使用するための準備は完了です。
今回は以上になります!
お疲れさまでした!
次回はEMRを立ち上げ実際に処理を行います。
[Renewal! Amazon EMR編~ElasticMapReduceの使い方パート②~]
次回記事: Renewal! Amazon EMR編~ElasticMapReduceの使い方パート②~
またお会いしましょう!

