
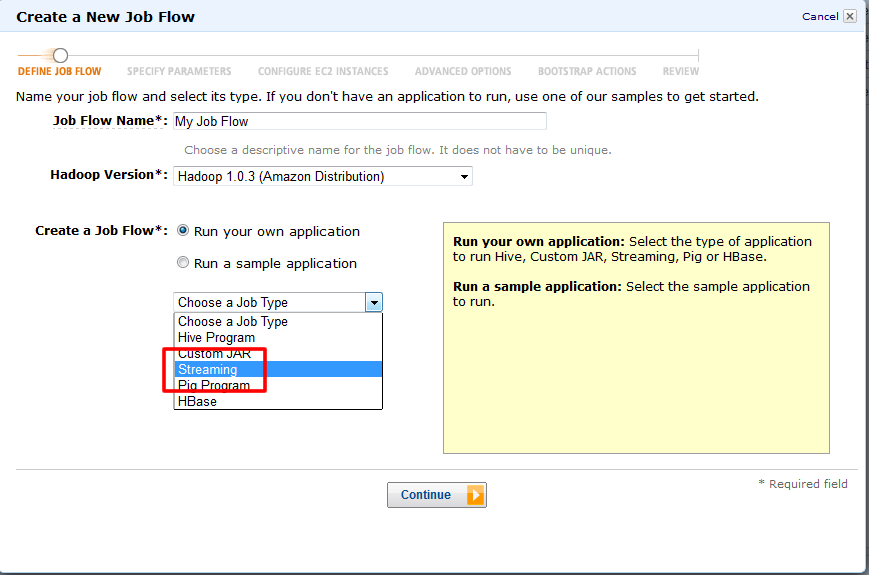
2.「Job Flow Name」にはそのまま「My Job Flow」で「Hadoop Version」はデフォルトを指定します。
3.「Create a Job Flow」では「Run your own application.」で「JobType」を「Streaming」に指定します。
データとプログラムの設定
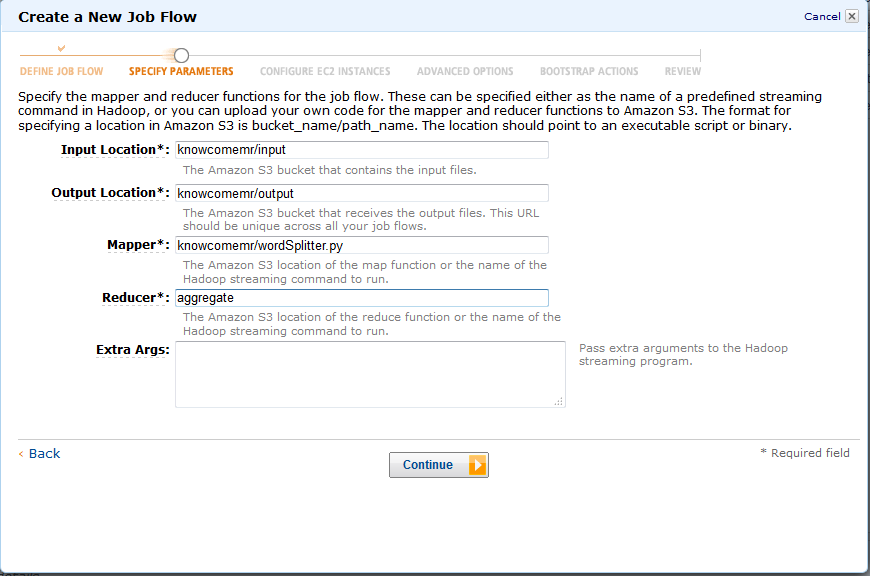
今回は以下を入力していきます。
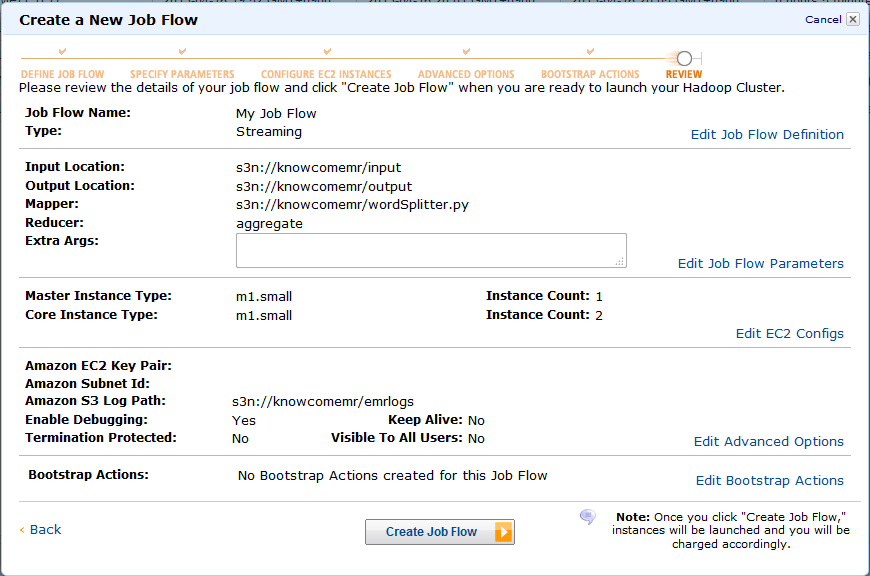
- Input Location: 作成したS3バケットのInputフォルダを指定します。
- Output Location: 作成したS3バケットのOutputフォルダを指定します。
6.Mapper: アップロードしたwordSplitter.pyのパスを指定します。
1. Reducer: Hadoopの「aggregate」クラスを指定します
- Extra Args: 空白にします。
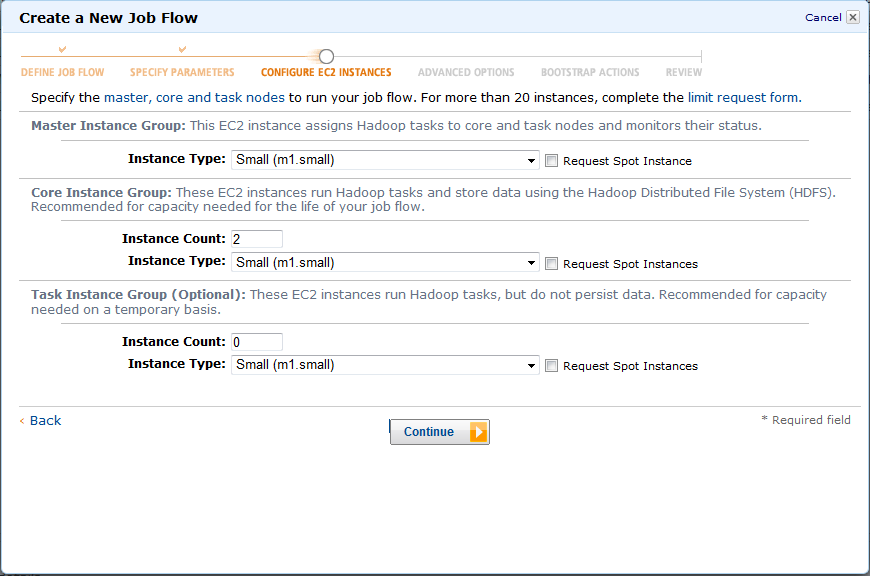
インスタンス設定
- インスタンス数やインスタンスタイプ等はデフォルトのままにします。
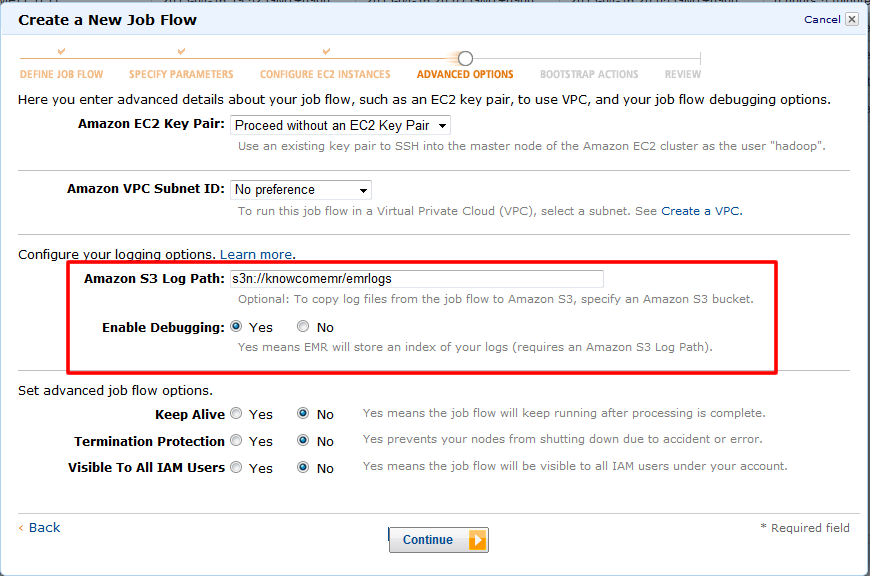
デバッグ設定
2. 今回はサンプルスクリプトを動かすだけなので、
デバッグとログファイルの指定場所だけを変更して進みます。
Bootstrap設定
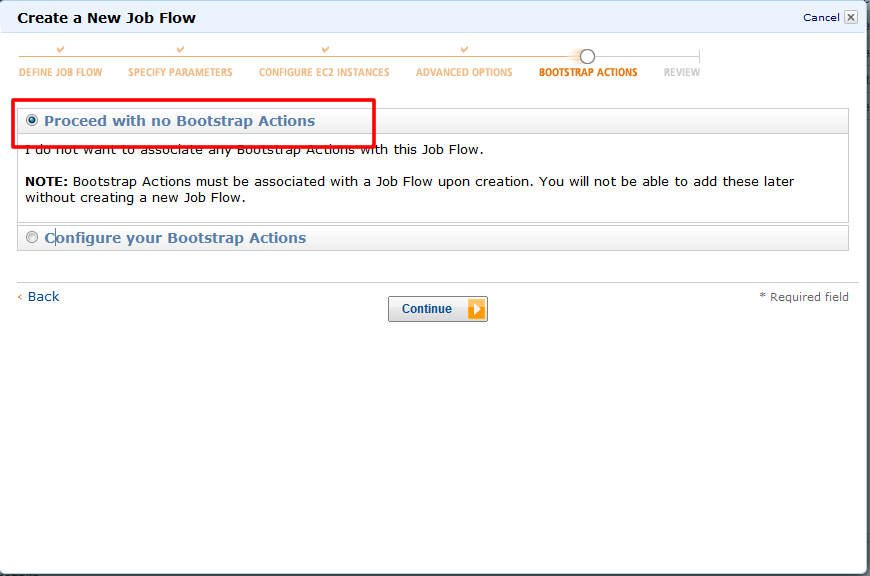
- 実行開始時の動作に関してもデフォルトで進みます。
3. 確認後、問題なければ起動してみましょう!
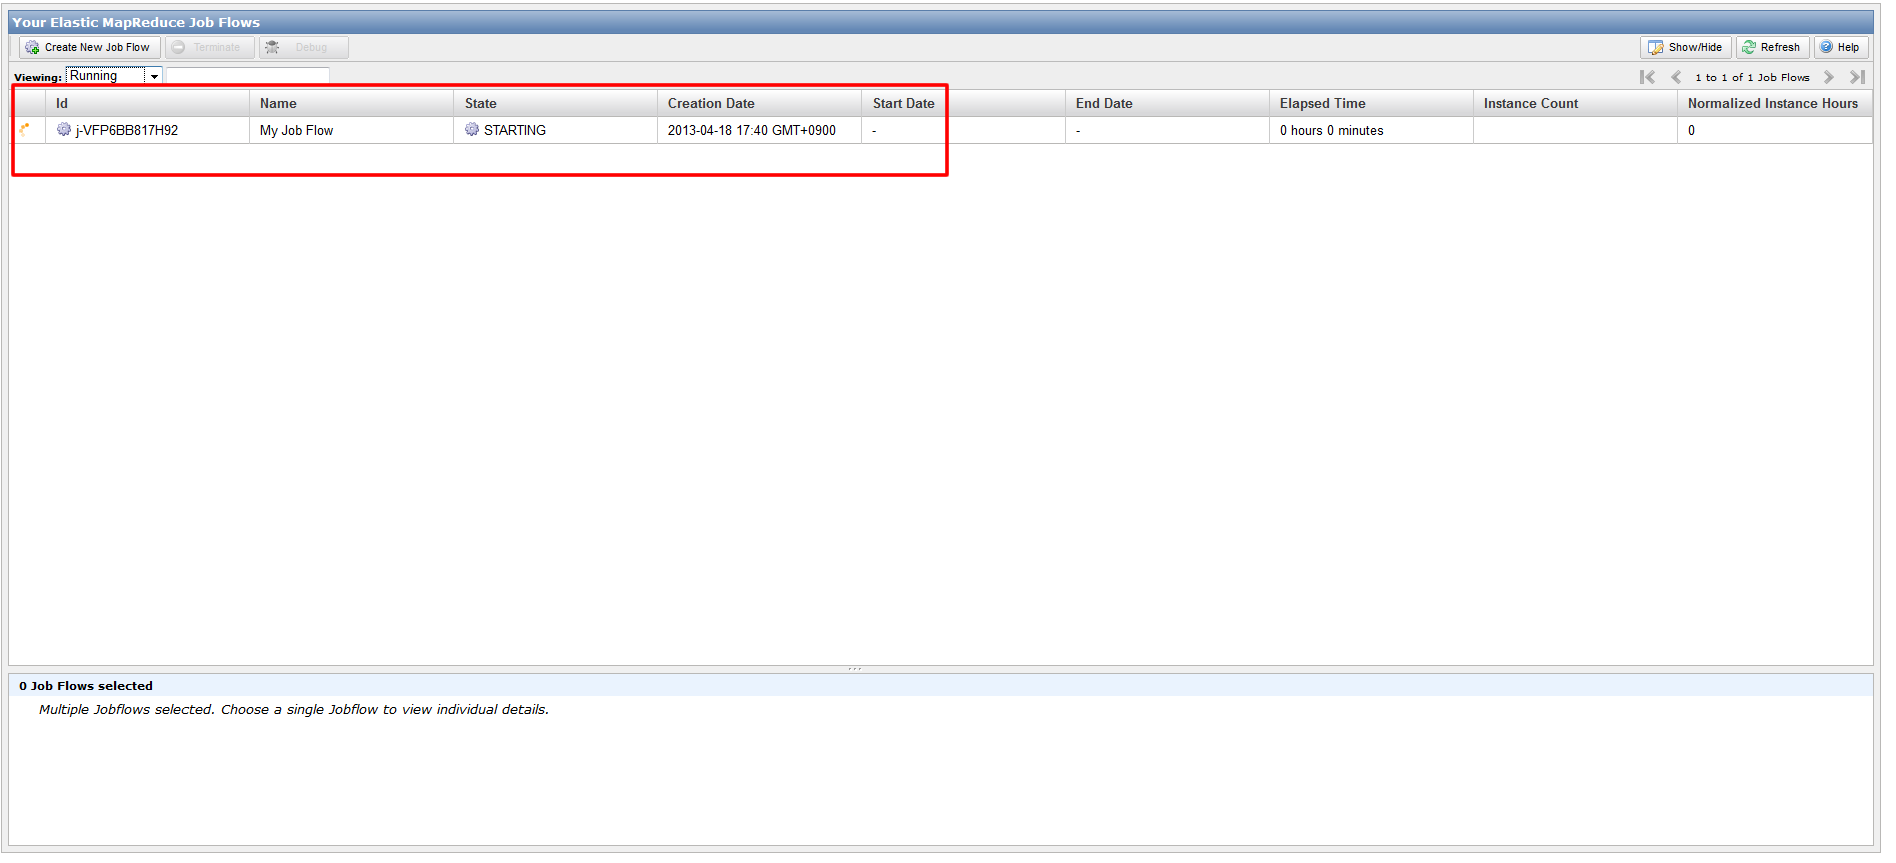
次回も『 Amazon EMR編~ElasticMapReduceの使い方パート③~ 』と題して、実際に出力された結果の確認を行いたいと思います。
お楽しみに!

