
上であげた3点について、詳細な実装方法を説明します。
ログ出力はloggerを使用して、環境変数によりロギングレベルを設定する
Pythonではloggerを利用することで、ログ出力をレベルに応じてハンドリングしてくれます。
さらに、Lambdaの環境変数を設けて、ロギングレベルを変更できるようにしました。
例えば、テスト時や障害調査時に、コード自体は変更することなく、ログ出力のレベルを変更できます。
サンプルコードは以下のようになります。
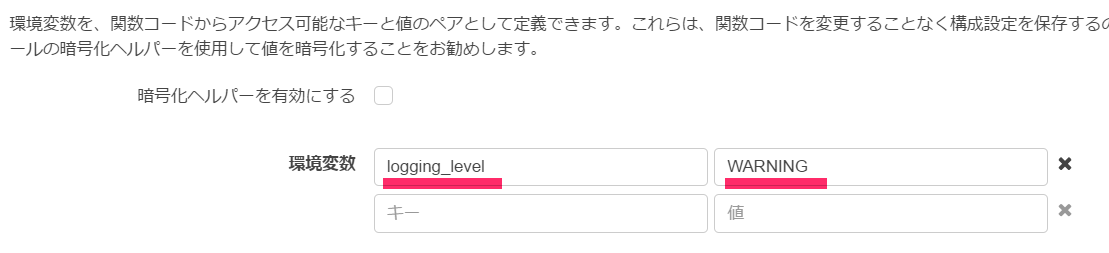
1import logging2import os34#Setting for logging5#Environment Variable 'logging_level' allows to control logging level 6logger = logging.getLogger()78logLevelTable={'DEBUG':logging.DEBUG,'INFO':logging.INFO,'WARNING':logging.WARNING,'ERROR':logging.ERROR,'CRITICAL':logging.CRITICAL}9if 'logging_level' in os.environ and os.environ['logging_level'] in logLevelTable :10 logLevel=logLevelTable[os.environ['logging_level']]11else:12 logLevel=logging.WARNING13logger.setLevel(logLevel)1415logger.info('Loading function')1617def lambda_handler(event, context):1819# ロギングレベルに応じてログを出力できる2021 logger.debug('1:debug')22 logger.info('2:info')23 logger.warning('3:warning')24 logger.error('4:error')25 logger.critical('5:critical')環境変数はインラインエディタの下にある入力フィールドで設定できます。
logging_levelログレベルに対してDEBUG/INFO/WARNING/ERROR/CRITICALを設定することでログの出力レベルを設定できるようにしました。
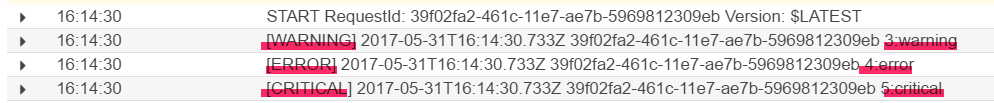
例えば、logging_levelをWARNINGに設定した場合以下のようなログが出力されます。
WARNING以上のレベルとして、ERRORとCRITICALも出力されていることが確認できます。
エラーケースに応じたハンドリングを行う
正常終了、異常終了(リトライあり)、異常終了(リトライなし)、リソース制約によるエラー(タイムアウトなど)をハンドリングしました。
Pythonの場合は各終了条件とコードは以下のように紐づけられます。
正常終了
returnで終了します。トリガーがS3のような非同期で呼ばれるものは、returnで何か値を返しても破棄されるので、戻り値で正常終了、異常終了を判断させることはできませんが、”normal end”を返すようにしています。
1# 正常終了させるケース2 if 正常終了の条件:3 logger.info("MODE : normal")4 return "normal end"異常終了(リトライなし)
loggerでErrorレベルのログを出力、returnで終了します。
returnの戻り値で正常終了、異常終了を判断させることはできないので、異常終了したことを、ログ出力で明示的に分かるようにしています。
1# 明示的に異常終了させるケース。リトライさせない2 if 異常終了の条件:3 logger.error("MODE : abend")4 return "abnormal end"異常終了(リトライあり)
raiseでエラーを明示的に発生させると異常終了し、リトライが動きます。
リトライは現在の仕様では最大2回行われます(最大3回までLambdaが実行される)。
1# 明示的に異常終了させるケース。リトライさせる2 if 異常終了の条件:3 logger.warning("MODE :retry")4 raise Exception("Inner Error")リソース制約によるエラー(タイムアウトなど)
トリガーがS3のような非同期で呼ばれるものは、リソース制約で異常終了すると、自動的にリトライされます。
Lambda関数内で、タイムアウトしたら何かを行う、といったことを明示的にコントロールすることはできません。
なお、Lambda関数に渡されるcontextオブジェクトのcontext.getremainingtimeinmillis()メソッドを呼び出せば、タイムアウトまでの時間を取得することができます。時間のかかる処理の場合は、残り時間を確認して、残りが少ない場合になんらかの処理を行うことも可能です。例えば、Lambdaから別のLambdaをキックして、処理を途中から再開する、というような使い方も可能です。
リトライしても正常終了しなかった場合はデッド・レター・キュー(Dead Leter Queue、DLQ)に入れて、通知させる
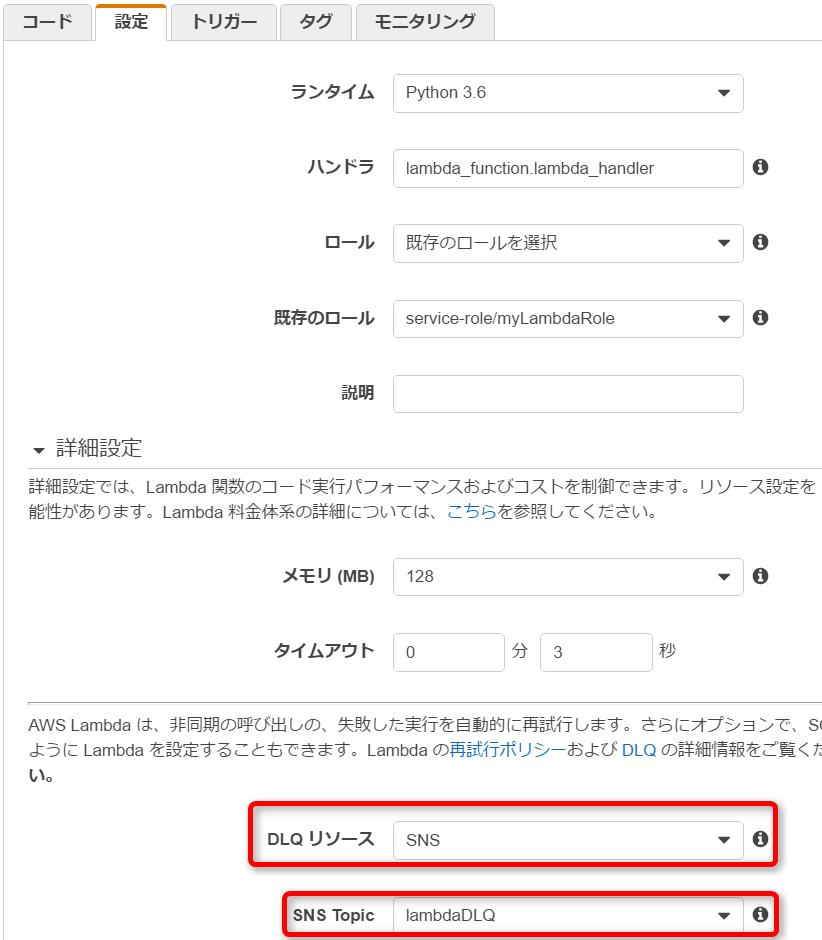
最大3回Lambdaが実行されても、正常終了されなかった場合は、DLQに入れることができます。
DLQとしてSQSとSNSが指定できます。以下の例ではSNSを選択し、SNS Topicを指定しています。今回の例ではSNSでメール通知させる設定をしてあります。
検証
以下のコードで検証していきます。
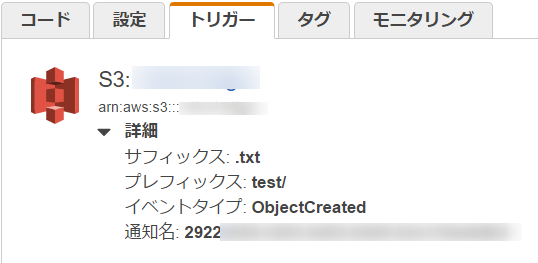
1import logging2import os3import urllib4from time import sleep5import re67#Setting for logging8#Environment Variable 'logging_level' allows to control logging level 9logger = logging.getLogger()1011logLevelTable={'DEBUG':logging.DEBUG,'INFO':logging.INFO,'WARNING':logging.WARNING,'ERROR':logging.ERROR,'CRITICAL':logging.CRITICAL}12if 'logging_level' in os.environ and os.environ['logging_level'] in logLevelTable :13 logLevel=logLevelTable[os.environ['logging_level']]14else:15 logLevel=logging.WARNING16logger.setLevel(logLevel)1718logger.info('Loading function')1920def lambda_handler(event, context):21 22# 検証のためトリガーになったS3のファイル名で条件分岐させる2324 key = event['Records'][0]['s3']['object']['key']25 26# 正常終了させるケース2728 if re.search(r"normal" , key):29 logger.info("MODE : normal")30 return "normal end"31 32# 明示的に異常終了させるケース。リトライさせない3334 if re.search(r"abend" , key):35 logger.error("MODE : abend")36 return "abnormal end"37 38# 明示的に異常終了させるケース。リトライさせる3940 if re.search(r"retry" , key):41 logger.warning("MODE :retry")42 raise Exception("Inner Error")4344# 明示的にタイムアウトさせてみる4546 if re.search(r"timeout" , key):47 logger.error("MODE : timeout")48 sleep(4)49 return50 51 returnトリガーはS3へのオブジェクトの作成を設定しています。
指定したS3バケットにファイルが格納されたり、ファイル名が変更されたりするとLambdaが起動されます。
正常終了
トリガーとなるバケットにnormal.txtを保存するとLambdaが起動して、以下のようなログが出力されます。
正常終了してINFOを出力しています。

異常終了(リトライなし)
トリガーとなるバケットにabend.txtを保存するとLambdaが起動して、以下のようなログが出力されます。
Lambda上は正常終了していますが、ERRORレベルのログを出力させています。

異常終了(リトライあり)
トリガーとなるバケットにretry.txtを保存するとLambdaが起動して、以下のようなログが出力されます。
例外(Exception)が出力されています。
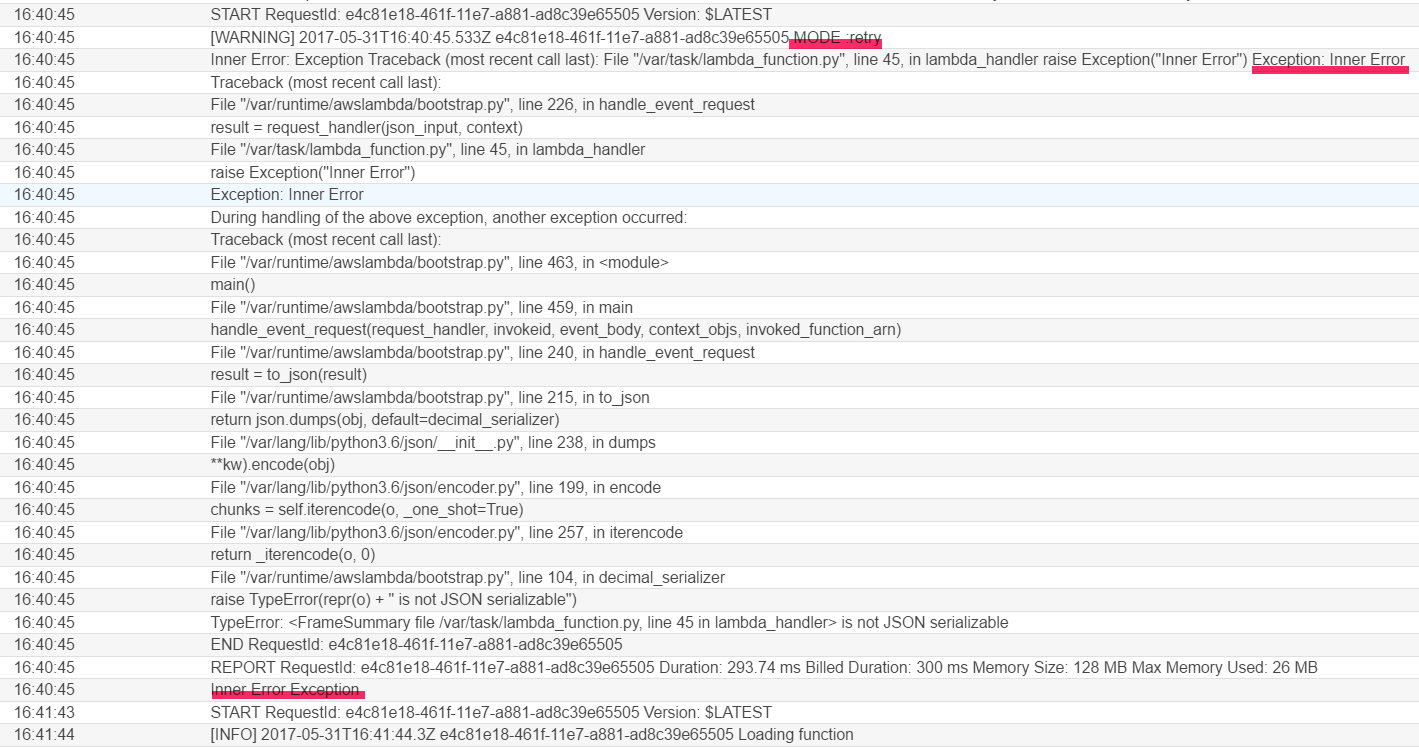
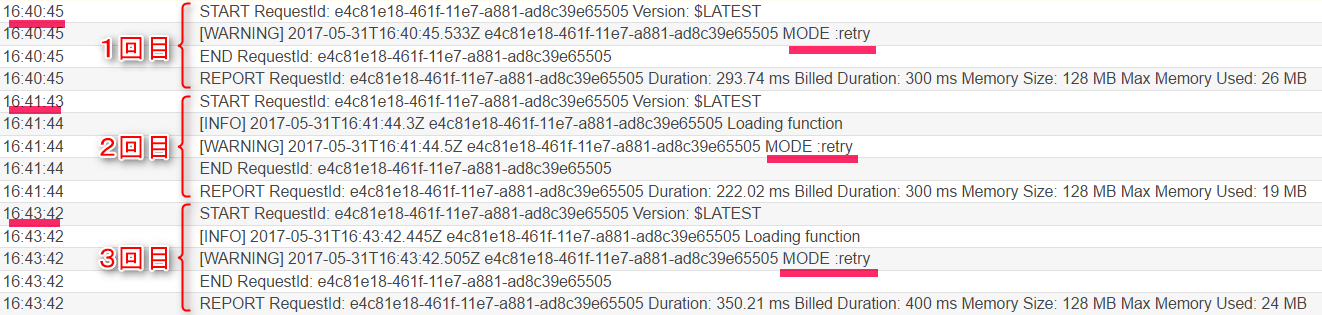
また、ログからリトライが発生し、合計3回実行されているのも分かります。
なお、1回目の実行から2回目の実行までは約1分、そして2回目の実行から3回目の実行までは約2分かかっています。
Exponential backoffというアルゴリズムで、再試行までの時間を1分、2分と長くしていく仕組みとなっているようです。
リソース制約によるエラー(タイムアウトの場合)
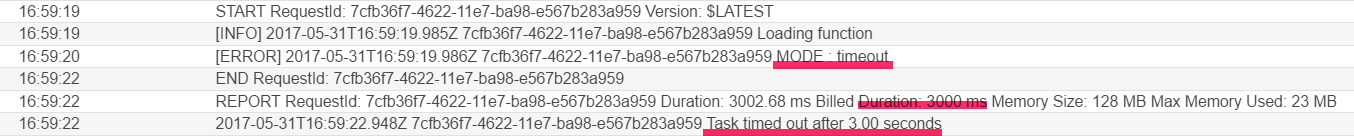
トリガーとなるバケットにtimeout.txtを保存するとLambdaが起動して、以下のようなログが出力されます。
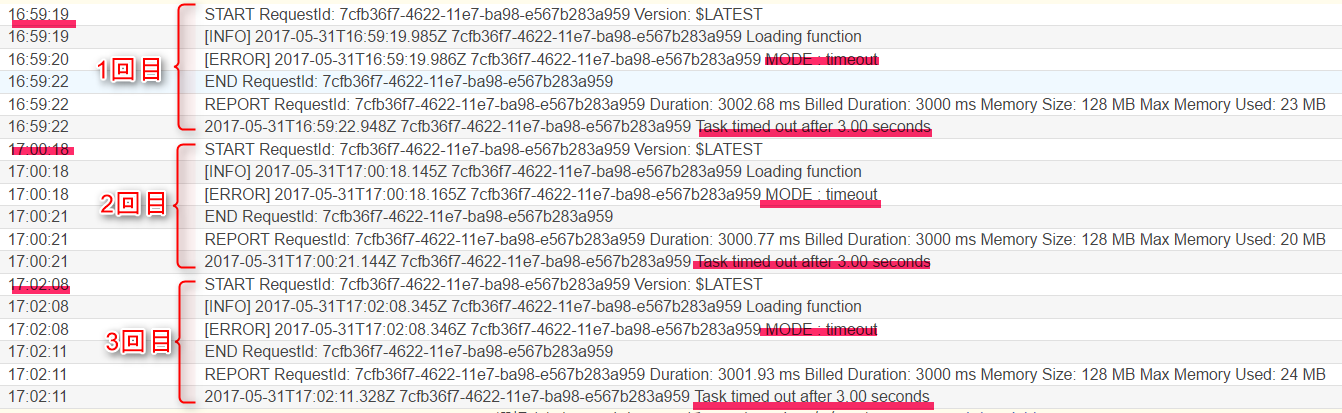
タイムアウトにより処理が終了しているのが分かります。
この場合も、Exponential backoffで、再試行までの時間が1分、2分と長くなっています。
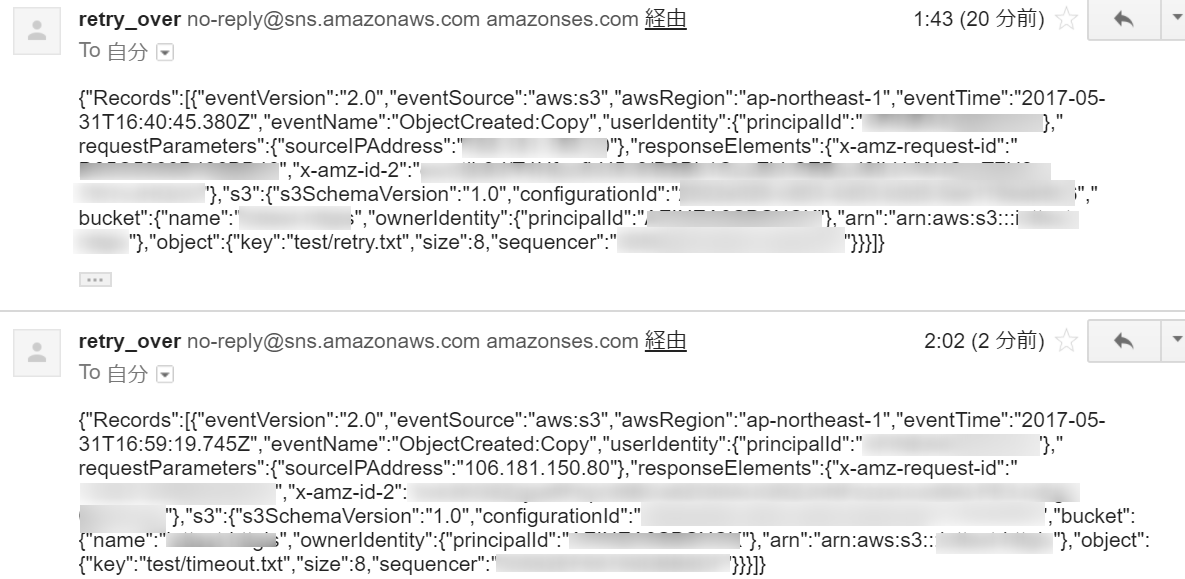
DLQへの通知内容
合計3回実行しても、リトライが失敗した場合は、DLQに登録され、SNSに連携、メールが送付されます。
今回の検証では異常終了(リトライあり)とリソース制約によるエラー(タイムアウトの場合)のケースの2件の通知が来ていました。
まとめ
loggerによるログ出力で、WARNINGやERRORなどレベルに応じたログを出力できることが確認できました。
CloudWatchでLambdaのログを監視すれば、エラー検知の仕組みを作ることもできます。
また、リトライオーバー(現状だと最大3回まで実行)時に通知する仕組みも構築できました。タイムアウト等で処理がNGになったことも検知できます。
Lambdaで提供されるメトリクスも組み合わせて活用すれば、Lambdaで構築した本番システムの監視が問題なくできそうです。
欲を言えば、リトライについては、リトライ回数もContextオブジェクトから取得できれば、さらに細かい稼働状況確認ができるので、今後の機能追加に期待しています。
最後までお読みいただき、ありがとうございました。

