
こんにちは!中の人です。
前回の『 Amazon Redshift編~パフォーマンスチューニング sortkey編~ 』『 Amazon Redshift編~パフォーマンスチューニング distkey編~ 』『 Amazon Redshift編~パフォーマンスチューニング 圧縮編~ 』のレシピでは、Redshiftのパフォーマンスチューニングとしてsortkey/distkey/圧縮の設定方法と、設定によるパフォーマンスの違いを紹介しました。
今回は『Amazon Redshift編~パフォーマンスチューニング まとめ編~』と題して、Redshiftのチューニング方法についてまとめます。
Sortkeyについて
カラムに最終更新日の様なデータがあるとします。
データは登録日時順となっており、最終更新日では並んでおりません。
ただし、集計上◯月◯日~□月□日に更新されたデータのみを集計したい場合ってありますよね?
例えば、最終来店日に対して、一定期間毎の売上単価や購買頻度を調べたいとします。
| ID | 購入者 | 登録日 | 最終来店日 |
|---|---|---|---|
| 1 | ユーザーA | 2012/12/24 | 2013/9/25 |
| 2 | ユーザーB | 2012/12/25 | 2013/1/1 |
| 3 | ユーザーC | 2012/12/26 | 2012/12/26 |
| 4 | ユーザーD | 2012/12/27 | 2013/5/1 |
| 5 | ユーザーE | 2012/12/28 | 2013/6/25 |
上記のようになっている場合、最終来店日を期間で集計する場合、全ての行を検索する必要があります。
サンプルのように5行程度であれば問題ないですが、数百万~数億レコードになった場合には大きく影響されます。
最終来店日にSortkeyを設定することで、以下の様な並び順となります。
| ID | 購入者 | 登録日 | 最終来店日 |
|---|---|---|---|
| 3 | ユーザーC | 2012/12/26 | 2012/12/26 |
| 2 | ユーザーB | 2012/12/25 | 2013/1/1 |
| 4 | ユーザーD | 2012/12/27 | 2013/5/1 |
| 5 | ユーザーE | 2012/12/28 | 2013/6/25 |
| 1 | ユーザーA | 2012/12/24 | 2013/9/25 |
Sortkeyを設定することで、Sortkeyを設定した項目の値順に並ぶようになります。
2013年1月~6月の上半期のデータの抽出を行う場合、2012年12月以前のデータや2013年7月以降は除外され、必要な部分のみ検索を行うことが出来ます。
この機能により、IDや期間などで絞り込みを行うカラムに対して設定を行うことで、高速化する事ができます。
Distkeyについて
Redshiftの強力な仕組みとして、複数のノードに対して分散して処理する仕組みがあります。
その分散処理を最適に利用するための設定がDistkeyとなります。
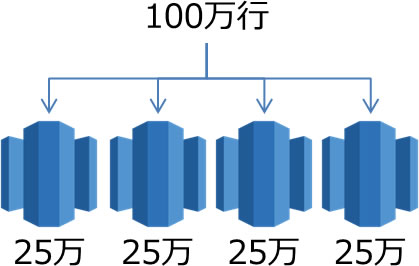
例えば、4ノードに対して100万行のデータを保存した場合、各25万行が保存される様になっております。
全体の20万行の値を取り出して集計処理を行う場合、ケースによっては以下のようになってしまう場合があり得ます。
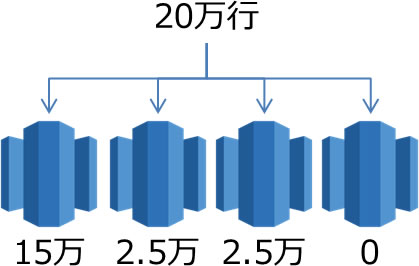
そんな時に設定するのがDistkeyとなります。
Redshiftでは設定したDistkeyが各ノードに均等に振り分けられるようにすることで、以下のように処理を行うようにしてパフォーマンスを発揮します。
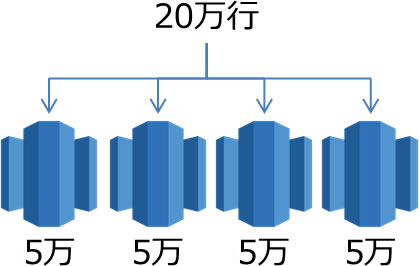
検索に利用され、ユニークな値を設定します。特にjoinに使う結合キーなどが向いており、複数のノードに正しく設置されることで、高速化する事ができます。
圧縮について
圧縮についてはいくつかの方法があります。
1つは空のテーブルに対して大量のレコードをS3からcopyした時に自動的に適用されます。
自動的に最適な圧縮方式としてもらえるというメリットが有りますが、
・ 空のテーブルに対して
・ 1sliceあたり10万件以上
のデータをcopyするという条件があります。
他にも現在のデータに対して、どの圧縮方式が最適と思われるかを診断する
・ ANALYZE COMPRESSION
という機能も提供されております。
手動で設定する方式としては
Delta
連続した値に対して効果が大きく、auto incrementするIDや時間といった連続するデータに対して効果が大きい圧縮方式
ByteDict
1ブロック当たりの要素が少ない(256個以下の)場合に値を辞書登録することで、データを圧縮する。
Text255
上記と似ており、245個の単語辞書を作る
Text32k
上記と似ており、32Kまで単語辞書を作る
Runlength
複数行に渡り、同じ行が繰り返される場合が多い時に効果的な圧縮方式。複数行をまとめて圧縮。
例えば、『あいうえお』という値が10行続く場合、『10,あいうえお』の様にすることで圧縮する。
ナレコムクラウドのFacebookに『いいね!』をクリックして頂くと
最新のお役立ちレシピが配信されます★

